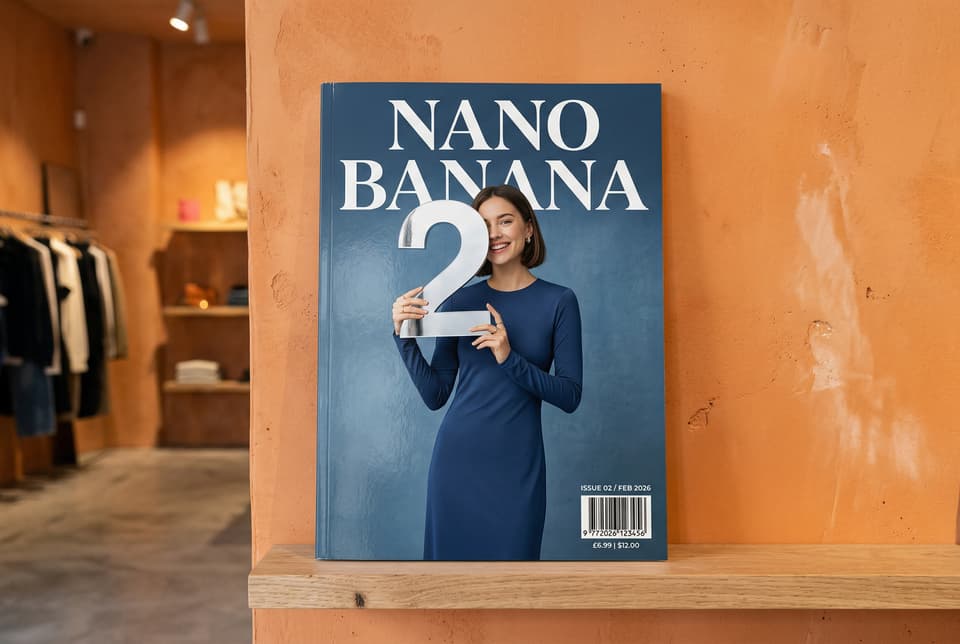
**文生圖(Text-to-Image,簡稱 T2I)**是一種生成式 AI 技術:你用文字描述一幅畫面,模型把它「畫」出來——構圖、光影、風格、細節,全部從你的文字生成。你負責描述,模型負責作畫。
工作原理
主流的文生圖模型底層是擴散模型(Diffusion Model),在海量「圖片+文字描述」配對資料上訓練而成。生成時,模型從純雜訊出發,在提示詞的引導下逐步「去噪」成一張完整圖片。新一代模型在擴散核心之上加入了語言模型前端,能把提示詞當作指令而非關鍵字堆來理解——空間關係(「杯子在書上面」)、物體數量、甚至圖片內的文字,準確率都大幅提升。
擅長的場景
當你只有文字、需要一張圖時,文生圖最能發揮價值:
- 概念圖與情緒板 —— 在確定方向之前,快速探索風格、配色與構圖。
- 行銷視覺 —— 頭圖、封面、橫幅、社群配圖,任意比例,不需要攝影棚。
- 批量插畫 —— 鎖定風格描述、只換主體,就能產出風格統一的系列插畫。
好的提示詞包含什麼
強大的 T2I 提示詞讀起來像美術指導的需求單。覆蓋四個要素:主體(畫面裡有什麼)、構圖(取景、視角、焦點)、風格(媒介、參考畫風、渲染方式)、光線與氛圍(黃昏逆光、霓虹夜色、柔和棚拍光)。具體永遠勝過籠統:「亞麻桌布上的陶瓷茶壺,俯拍,柔和窗光,極簡產品攝影」遠好於「一個好看的茶壺」。